O file server sumiu, o backup existia — e mesmo assim o dia foi longo
Por Global Data Solutions
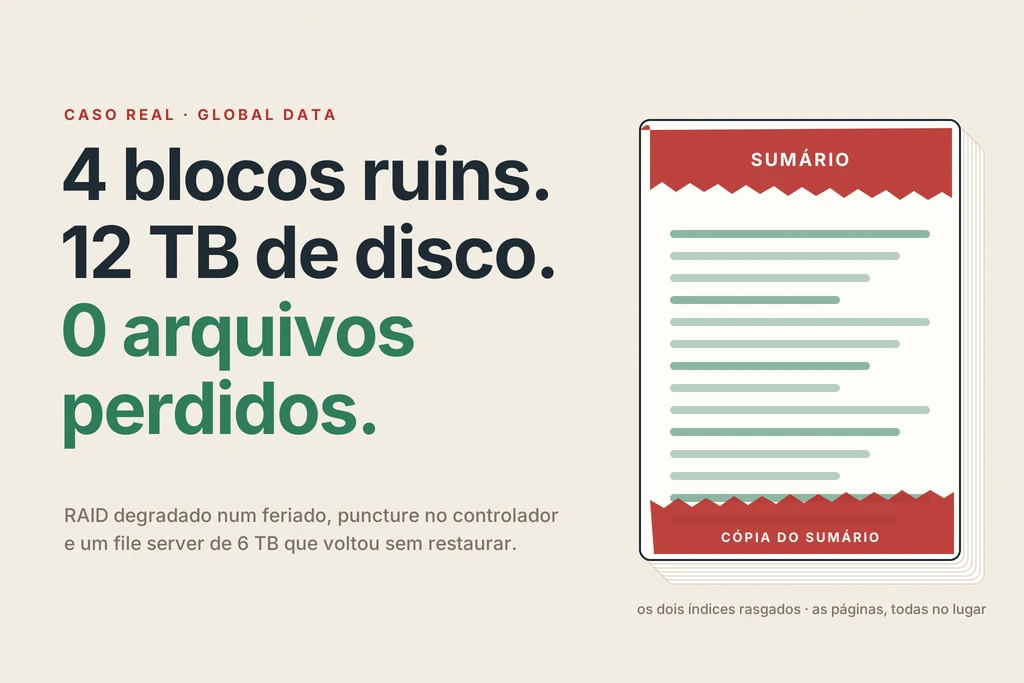
Resumo: Um disco do RAID 1 morreu no feriado e o monitoramento avisou. Antes de o disco novo chegar, o sobrevivente expôs setores ruins exatamente nas tabelas de partição, e o controlador passou a recusá-los. O volume de 6 TB do file server sumiu — mas os dados estavam intactos. Reescrevemos o índice com TestDisk e gdisk, o file server voltou em uma tarde, e o pós-mortem definiu o que faltava: disco reserva em estoque, backup local além da nuvem e um plano de DR escrito antes do desastre.
Numa madrugada de terça para quarta, o monitoramento da Global Data acusou que o volume de dados do file server de uma empresa cliente tinha parado de responder. O servidor estava ligado, a máquina virtual respondia, mas o disco de 6 TB com todos os arquivos da operação aparecia no Windows como uma partição vazia e um espaço “não alocado”. Ninguém tinha apagado nada. E não foi surpresa: dois dias antes, no feriado, o mesmo monitoramento já tinha avisado que um dos discos do RAID havia morrido.
A empresa tinha backup — em nuvem, porque é regra em todo contrato da Global Data. Mas restaurar 6 TB pela internet leva dias, e restaurar em cima de um disco que pode estar com defeito é restaurar duas vezes. Antes de acionar o backup, precisávamos responder duas perguntas: o que aconteceu e em que hardware é seguro voltar.
Este artigo conta o caso do início ao fim: o que o monitoramento viu, o que os logs provaram, o que quase nos levou para o caminho errado, como recuperamos sem restaurar — e, com a mesma franqueza, o que faltava no ambiente para que um disco queimado tivesse sido um chamado de rotina. O cliente não é identificado; a infraestrutura é comum a milhares de PMEs brasileiras: um servidor Dell PowerEdge com controladora RAID, Hyper-V e uma VM de arquivos.
O que aconteceu, na ordem em que aconteceu
O ambiente: um PowerEdge com controladora PERC H330, um SSD para o sistema do host e dois pares de discos em RAID 1 (espelhamento). O par de 12 TB guardava o arquivo de disco virtual (VHDX) de 6 TB do file server. Tolerância a falhas: um disco.
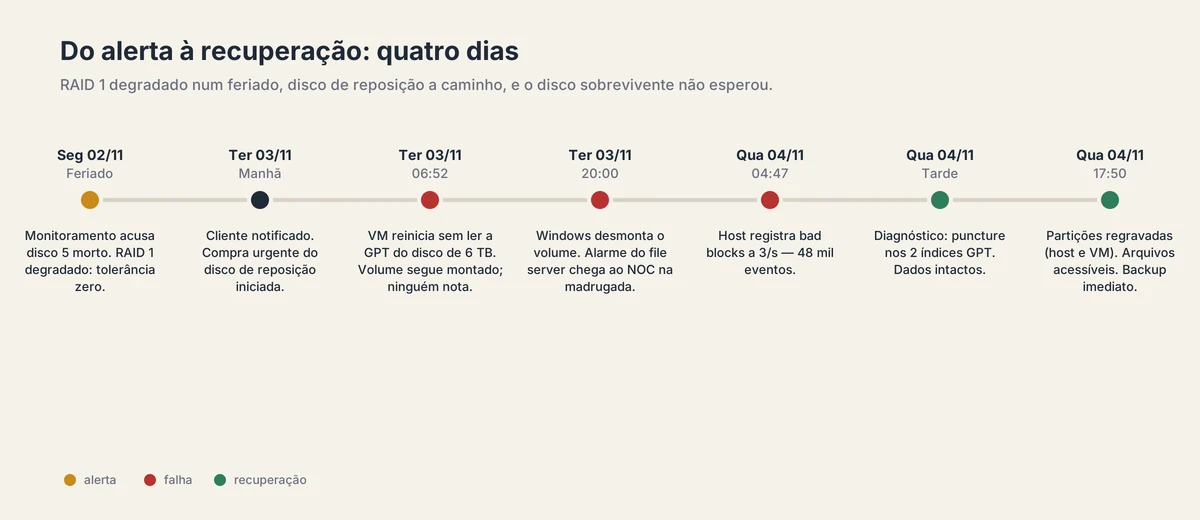
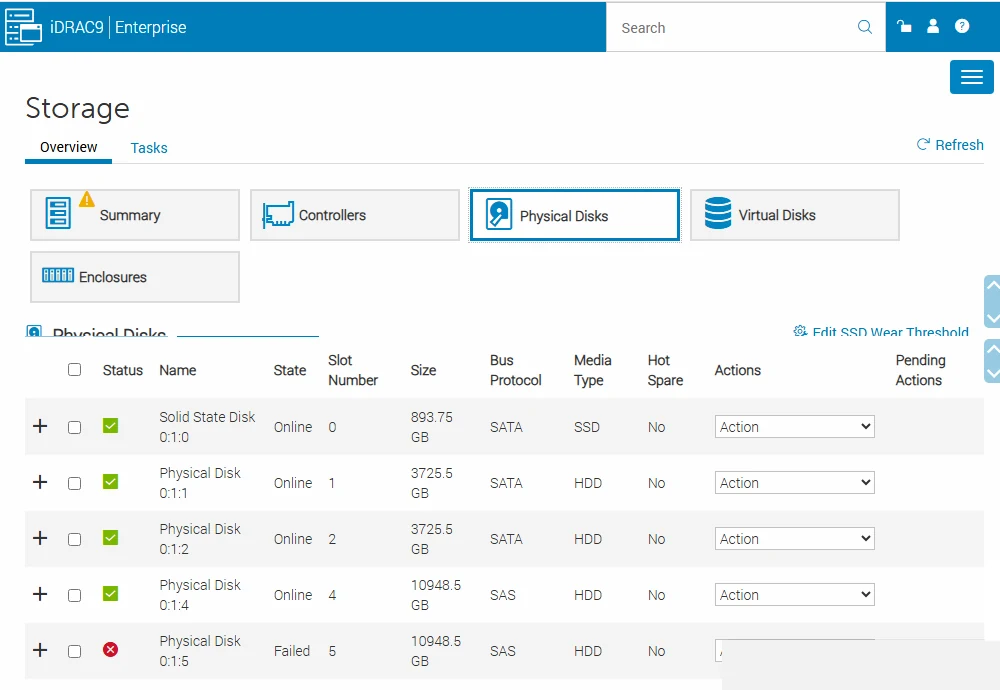
Segunda-feira, 2 de novembro — feriado de Finados. O sensor de iDRAC do PRTG, que a Global Data mantém em todo servidor Dell que monitora pelo NOC, acusou o disco 5 como morto. RAID 1 degradado, rodando no disco sobrevivente. Num feriado não há fornecedor para despachar peça nem equipe no cliente para trocar.
Terça-feira, 3 de novembro, manhã. Notificamos o cliente: um dos dois discos falhou, a tolerância agora é zero, e se o segundo falhar para parte da infraestrutura — o volume de dados do file server mora ali. Compra urgente do disco de reposição aberta. O dia passou sem incidentes aparentes.
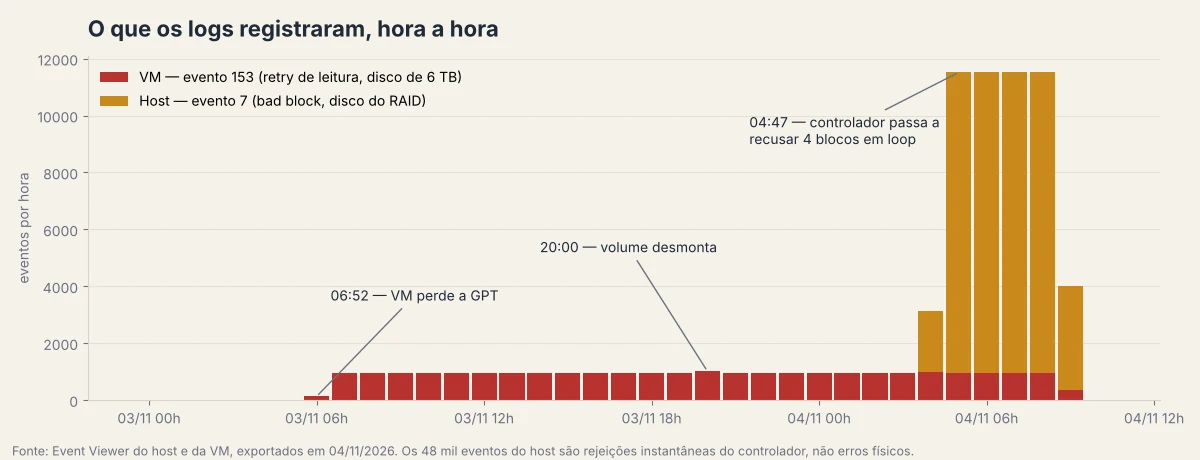
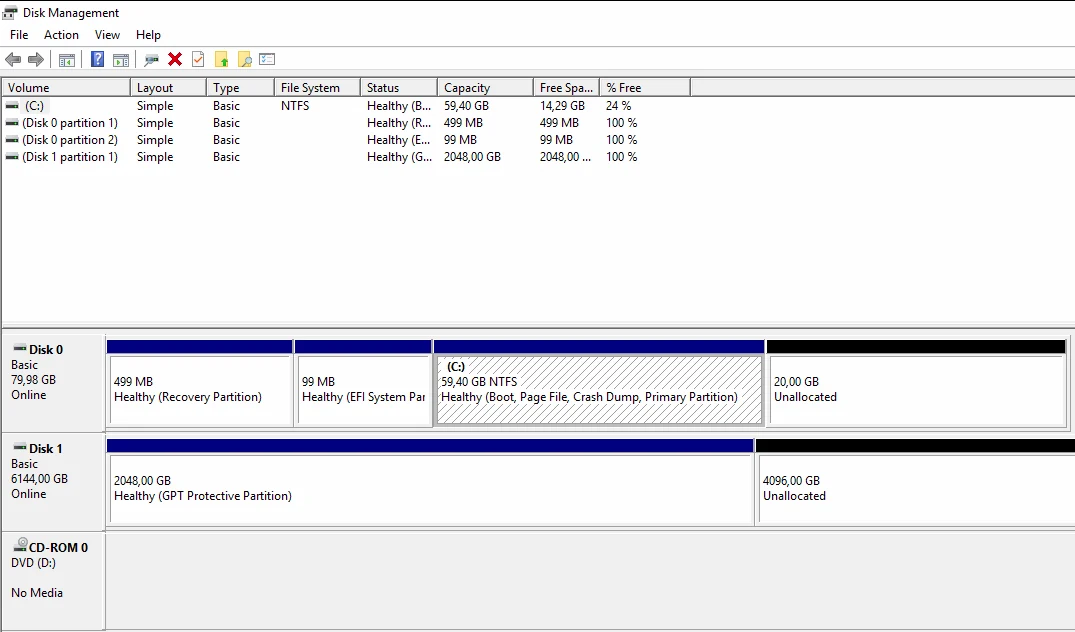
Terça-feira, 06:52 — o que ninguém viu na hora. Os logs mostram que a VM do file server reiniciou de forma inesperada e, ao subir, não conseguiu ler a tabela de partições do disco de 6 TB. O Windows passou a registrar o mesmo aviso a cada quatro segundos: “The IO operation at logical block address 0x2 for Disk 1 was retried”. O endereço 0x2 é onde o GPT guarda a lista de partições. O volume continuou montado por inércia, servindo arquivos, e por isso o dia pareceu normal.
Terça-feira, 20:00. O Windows desmontou o volume. Na madrugada, o monitoramento acusou o segundo alarme — desta vez não do disco físico, mas do volume de armazenamento do file server. A partir daí, a partição “sumiu”.
Quarta-feira, 04:47. O host começou a registrar erros de bad block no disco do RAID, a três por segundo. Quando a equipe foi olhar, eram 48 mil eventos.
Quarta-feira, à tarde. Após atualizar o firmware do iDRAC e a BIOS, o host reiniciou — e o próprio volume do host onde o VHDX morava deixou de aparecer. O mesmo sintoma, um nível acima.
A causa raiz: o disco que “estava ok” não estava
O iDRAC mostrava o disco sobrevivente como Online, sem falha prevista. É aqui que a maioria dos diagnósticos para — e erra.
Discos mecânicos de grande capacidade acumulam, ao longo dos anos, setores com erro latente de leitura. Em operação normal ninguém nota: quando o controlador tropeça num setor ruim de um disco, lê a cópia do outro e corrige em silêncio. Isso é o RAID 1 fazendo o trabalho dele. O problema é o que acontece quando o espelho morre: o disco sobrevivente passa a ser a única fonte, e cada setor latente que ele carregava vira um erro visível.
Nos controladores Dell PERC (e na família LSI/Broadcom em geral), esse erro tem um tratamento específico chamado puncture: o controlador marca o bloco numa tabela interna de blocos ruins e, a partir daí, recusa qualquer leitura dele instantaneamente, sem nem consultar o disco. Foi isso que explicou os 48 mil eventos a três por segundo — não eram 48 mil erros de mídia, era o Windows pedindo os mesmos quatro blocos em loop e o controlador negando na hora.
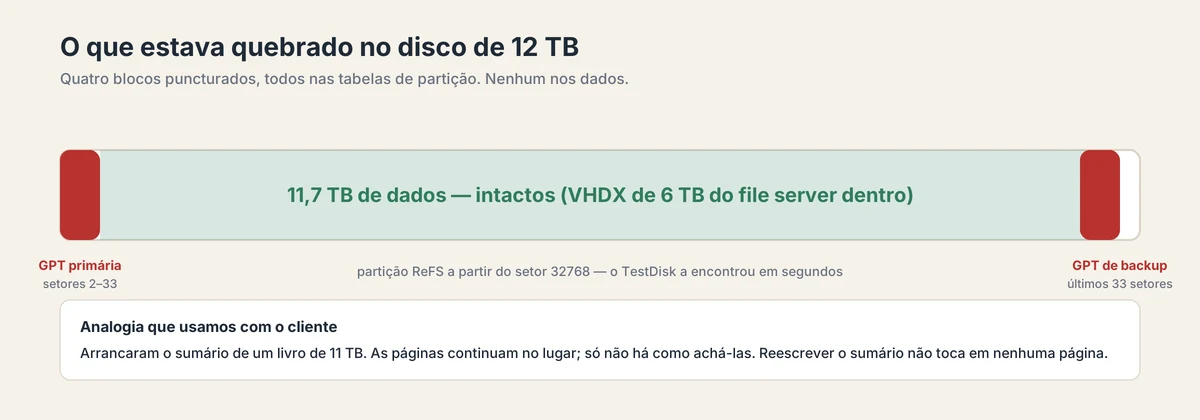
A confirmação veio da ferramenta de linha de comando do controlador (PERCCLI). A tabela de bad blocks do volume tinha quatro entradas não corrigidas, e o log interno mostrava exatamente quais: os blocos da tabela GPT primária e os da tabela GPT de backup. Os dois índices do disco, puncturados. Os dados, intocados.
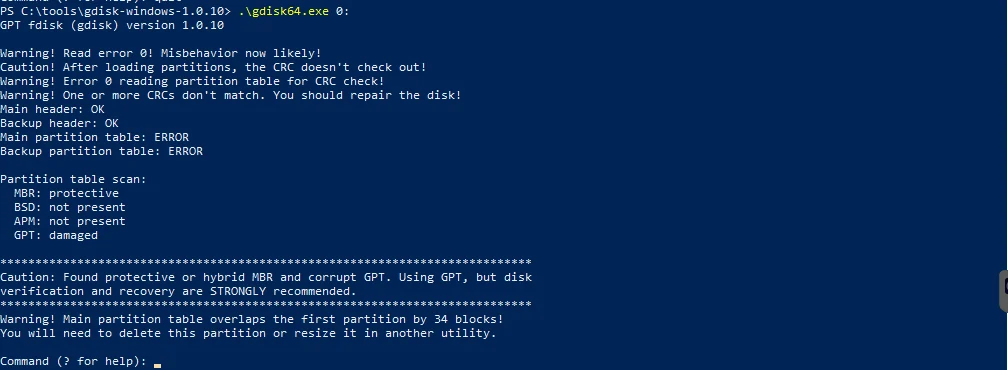
O gdisk resumiu o estado em quatro linhas: os dois cabeçalhos GPT legíveis, as duas tabelas de partição ilegíveis.
Um detalhe que pesa na decisão de hardware: os dois discos de 12 TB tinham o mesmo modelo e números de série do mesmo lote. Quando um disco de um par falha, a probabilidade de o irmão estar perto não é teórica.
O alerta chegou. O que faltou foi tempo de resposta
Vale ser preciso sobre o que funcionou e o que não funcionou, porque a lição está na diferença.
O monitoramento funcionou. O disco morreu num feriado e o PRTG avisou no mesmo dia. No primeiro dia útil o cliente foi notificado, com o risco explicado em uma frase: tolerância zero, e se o segundo disco for, parte da infraestrutura para. A compra do disco de reposição foi aberta na hora.
O que não existia era margem. Entre o alerta e a chegada de um disco SAS de 12 TB há dias — cotação, aprovação, logística. O disco sobrevivente não esperou. Sem disco reserva em estoque, sem backup local para uma restauração rápida e sem um procedimento de desastre escrito, cada hora de RAID degradado era uma hora de aposta. O monitoramento comprou a informação; faltava o que fazer com ela em 24 horas.
Um detalhe que reforça por que monitoramos de fora. O Lifecycle Log do próprio iDRAC tinha um buraco de dez dias sem nenhum evento — nem a falha do disco, nem o RAID degradado. O iDRAC só registrou a falha quando foi reiniciado, depois da atualização de firmware. Se o alerta dependesse do e-mail do iDRAC, ele não teria chegado. Chegou porque o PRTG consulta o iDRAC ativamente, de fora, e sabe reclamar quando a resposta muda — ou quando para de vir.
E a falsa pista. No meio do caminho, o log do nobreak mostrava “bateria descarregada” na noite anterior. Queda de energia explicaria tudo. Mas os eventos da VM contavam outra história: o aviso de retry vinha sendo gravado 160 vezes a cada dez minutos, sem uma única interrupção, atravessando o horário do suposto apagão. O servidor nunca desligou. O nobreak registrava sobretensão da rede e uma bateria no fim da vida — outro item para a lista de correções, não a causa. A cronologia dos logs vale mais do que a hipótese mais confortável: cruzamos log do host, log da VM, Lifecycle Log e log interno do controlador, e foi o cruzamento que fechou o diagnóstico.
Como recuperamos sem restaurar 6 TB
Com a causa entendida, a recuperação ficou mais simples do que parecia. Reescrever o sumário não toca em nenhuma página.
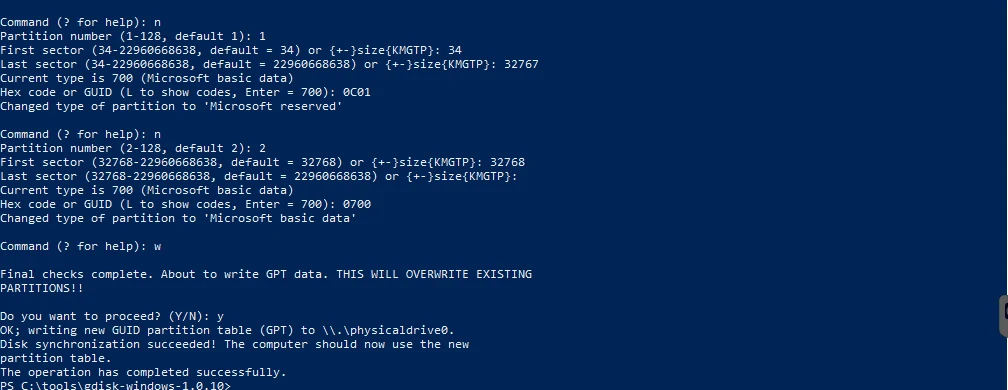
Dois comportamentos do controlador tornaram isso possível. Primeiro, o layout de um disco GPT criado pelo Windows é previsível: partição reservada nos setores 34 a 32767, dados a partir do setor 32768. Segundo, uma escrita bem-sucedida num bloco puncturado limpa a marcação do controlador. Ou seja: gravar uma tabela GPT nova nos mesmos blocos resolvia o índice e o puncture ao mesmo tempo.
O roteiro, primeiro no host e depois dentro da VM:
- TestDisk para confirmar o início da partição — ele encontrou a assinatura do sistema de arquivos exatamente no setor 32768, em segundos. No host o volume era ReFS, formato que o TestDisk não dimensiona; dentro da VM era NTFS e ele validou a partição inteira sozinho.
- gdisk para gravar uma GPT nova com os setores declarados à mão, sem depender da leitura dos blocos bloqueados.
- Reinício e verificação: o volume do host voltou com o VHDX intacto; a VM subiu com o disco de 6 TB e os arquivos acessíveis.
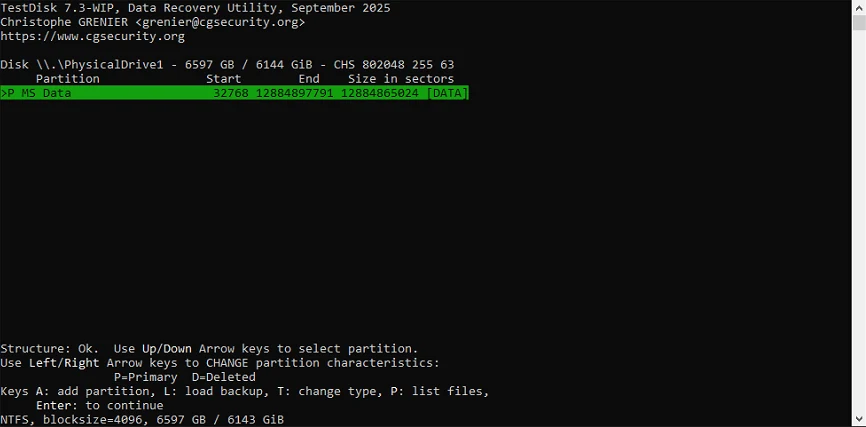
Houve um obstáculo digno de nota: na primeira tentativa, a gravação falhou com um erro genérico. A proteção anti-ransomware do software de backup, que vigia escritas no setor de boot, bloqueou a ferramenta — fazendo exatamente o que deveria fazer. Desativada por alguns minutos, a gravação passou.
O que não fizemos, e que teria destruído os dados: aceitar o “Inicializar disco” que o Windows oferece, formatar o espaço “não alocado”, rodar chkdsk /f antes do backup ou deixar o controlador reconstruir o RAID em cima do disco suspeito. Em recuperação, a lista do que não fazer é tão importante quanto o roteiro.
O primeiro comando depois de o volume voltar foi um backup incremental. Só depois de ele terminar os usuários foram liberados.
O que esse caso ensina a quem tem servidor na empresa
RAID não é backup, e RAID degradado é um relógio correndo. O espelho comprou dois dias de funcionamento aparente — e foram esses dois dias que deram tempo para o disco sobrevivente expor seus defeitos. Um disco falhado precisa ser trocado em horas, não quando a compra chegar. Isso só é possível com disco reserva em estoque, do mesmo modelo, guardado no cliente ou na Global Data.
Backup em nuvem e backup local não competem; respondem a perguntas diferentes. A nuvem protege contra o desastre no site — incêndio, roubo, ransomware que criptografa tudo que vê, erro humano que apaga um volume. É a rede de segurança final, e aqui ela existia e estava válida. Mas restaurar 6 TB pela internet leva dias, e nesse tempo a empresa fica parada. O backup local — um storage no próprio cliente com a cópia mais recente — responde à pergunta “quanto tempo até voltar”: horas, não dias. É a regra 3-2-1 na prática: três cópias, dois tipos de mídia, uma fora do site. Faltou a cópia local, e isso transformou “restaurar” numa opção de último caso em vez da primeira.
Procedimento de desastre se escreve antes do desastre. Quem decide o quê, em que ordem, com que ferramenta, quando acionar o backup, quando tentar recuperar, quem avisa o cliente e o quê. Não tínhamos isso escrito para este ambiente, e cada decisão foi tomada no calor da hora — deu certo, mas custou um dia de análise que um runbook teria encurtado.
“Online” no painel não significa saudável. Contadores de erro de mídia, tabela de bad blocks e log interno do controlador só aparecem na linha de comando. Ter o PERCCLI (ou equivalente do fabricante) no kit padrão de todo servidor é o que separa um diagnóstico de um chute.
O alertador também precisa ser monitorado. O iDRAC manda e-mail quando um disco falha; não manda nada quando ele próprio trava. Monitorar o iDRAC como alvo, de fora, foi o que fez o alerta chegar neste caso.
Firmware e bateria de nobreak fazem parte da infraestrutura. O iDRAC estava em firmware antigo; o nobreak, com bateria morta numa rede com sobretensão. Nenhum dos dois causou o incidente, e os dois teriam piorado o próximo. Monitorar o nobreak teria mostrado a bateria antes.
Pós-mortem: o que mudou depois deste caso
Todo incidente na Global Data termina com a mesma pergunta: o que, no processo, deixou isso acontecer, e o que muda para o próximo. Neste caso, a resposta tem cinco itens, e nenhum deles é “comprar um servidor novo”.
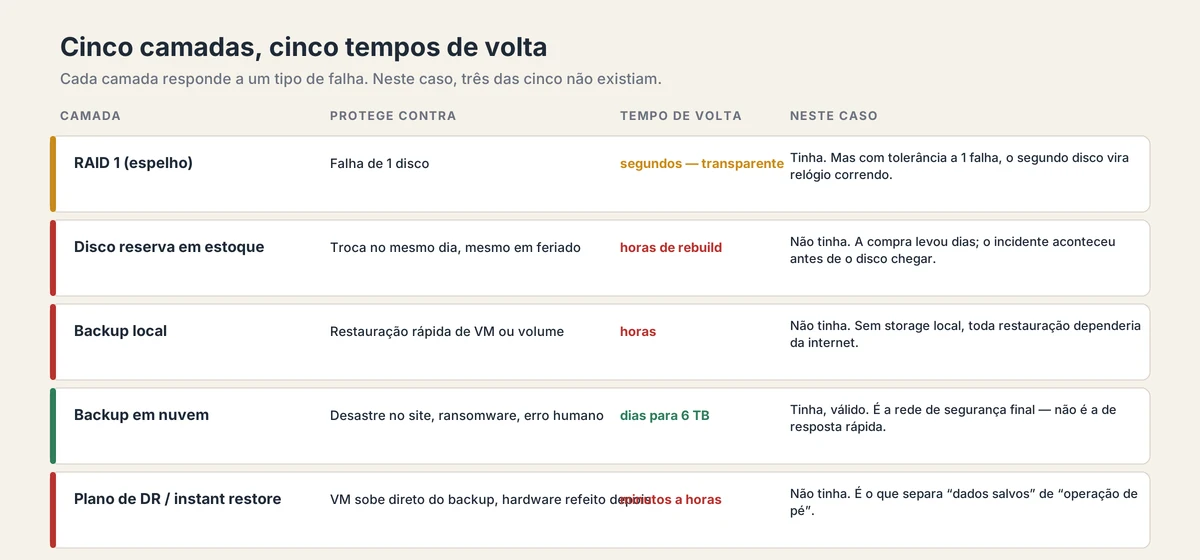
- Disco reserva em estoque. Um disco do mesmo modelo, guardado, para troca no mesmo dia — feriado incluído. Custa uma fração do que custou este incidente em horas de equipe e de operação parada. O RAID volta a ter tolerância a falhas em horas de rebuild, não em dias de cotação.
- Backup local, além da nuvem. Um storage no cliente recebendo a cópia diária das VMs, com a nuvem como segunda cópia. Restauração de VM inteira em horas, pela rede local. A nuvem continua sendo a proteção contra o desastre grande; o local passa a ser a proteção contra o desastre comum.
- Plano de DR com instant restore. Com repositório local, o software de backup consegue subir a VM direto do arquivo de backup em minutos, enquanto o hardware é refeito por trás. É o que separa “os dados estão salvos” de “a empresa está operando”. O tempo de volta cai de dias para o tempo de um reboot.
- Runbook de desastre por ambiente. Um documento curto, por cliente: o que monitorar, quem aciona quem, a ordem de decisões (recuperar ou restaurar?), as ferramentas no kit e o que não fazer. Escrito agora, com este caso fresco.
- Higiene do servidor. Patrol Read e Consistency Check periódicos no controlador (é o que expõe setor latente enquanto o espelho ainda corrige), firmware do iDRAC em ciclo de atualização, bateria do nobreak trocada, e o próprio iDRAC como alvo de monitoramento — que já era, e foi o que salvou o dia.
O cliente segue operando no disco sobrevivente até os novos chegarem, com backup diário e os olhos do NOC em cima. Quando chegarem: backup final, volume RAID recriado do zero com inicialização completa — que zera a tabela de bad blocks — e restauração.
Sua empresa saberia se um disco do servidor falhasse hoje?
Se a resposta depende de alguém olhar um painel, a resposta é não. E se a resposta é “sim, mas o disco novo chega em uma semana”, a pergunta certa é outra: quanto tempo a operação aguenta parada? A Global Data assume o monitoramento e a gestão do ambiente de TI de PMEs para que uma falha de disco seja um chamado de rotina — com peça em estoque, backup local e em nuvem, e um plano de retorno escrito antes de ser necessário.
Solicite uma avaliação do seu ambiente de TI e saiba em que estado estão o RAID, o backup e o monitoramento dos seus servidores.
Este artigo foi escrito a partir dos logs, prints e decisões de um atendimento real da Global Data em novembro de 2026, com apoio de IA na redação. O diagnóstico, as escolhas e a revisão técnica são da nossa equipe. O cliente não é identificado e os prints foram editados para remover qualquer dado que o identifique.
Serviço relacionado: conheça o serviço de monitoramento de redes e NOC 24x7 da Global Data.
Quer ajuda especializada com a TI da sua empresa?
Fale com um especialista